Temps de lecture : 11 minutes
mots-clés : halupedia, IAG, IGA, modèle algorithmiques, technologie hardware, informatique quantique
Nombre de pages « équivalent » : 4
Article rédigé avec l’aide de l’IA : non (sauf le résumé de 3 lignes)
En bref : Le texte compare Wikipédia, Grokipédia et Halupédia pour montrer que toute source, humaine ou algorithmique, exige un regard critique. Halupédia, fondée sur des contenus volontairement inventés par l’IA, illustre les hallucinations des modèles actuels et la nécessité d’une intelligence artificielle plus fiable. Mind Simulation défend une approche hybride combinant raisonnement symbolique, apprentissage automatique et intervention humaine afin de progresser vers l’IAG. L’auteur conclut que cette évolution dépendra autant de la confiance accordée aux machines que des limites matérielles, énergétiques et environnementales de leur puissance de calcul.
Chers lecteurs, chères lectrices,
Chers abonné.e.s,
La question est dans le titre, connaissez-vous Wikipédia ? Oui, bien sûr.
Pour rappel, Wikipédia est une fondation sans but lucratif et 50% de son financement est essentiellement issu du groupe Alphabet (Google) , le reste étant des donations individuelles et institutionnelles (au sens américain du terme).
Connaissez-vous Grokipédia, l’un des avatars d’E. Musk, considérant que Wiki était rempli de « gauchos » (Numérama, 23 octobre 2023).
Précisons toutefois et en toute connaissance que Gorkipédia n’est pas si mauvais que cela, pour autant qu’on fasse suffisamment état d’un regard critique. Je me souviens de cet étudiant dont j’étais le directeur de Thèse et qui est venu m’expliquer que le sujet sur lequel il travaillait allait toujours dans le même sens critique lorsqu’il effectuait ses recherches. Il décida d’utiliser l’outil de Musk… qui prenait le contre-pied et lui a permis d’approfondir son travail, retrouvant ainsi des articles scientifiques moins consensuels. Bref, rien n’est blanc, rien n’est noir, tout est question d’esprit critique.
Reste à connaitre Halupédia, un site de référencement entièrement alimenté par des hallucinations d’IA ! La raison d’être de ce site est que tout doit être inventé par les IA. Nous vous conseillons une visite, car, de manière détournée, elle montre qu’une IAG est capable de faire des erreurs, beaucoup d’erreurs.
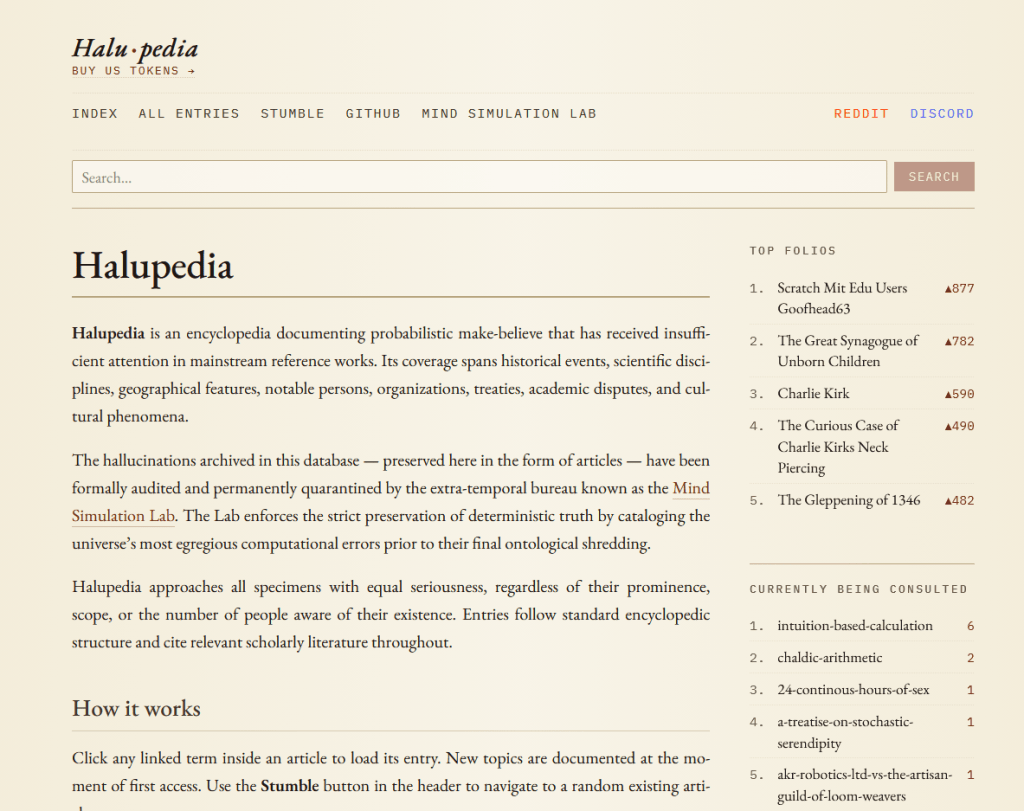
Un exemple de sérendipité…
Plus qu’un long discours, nous vous proposons une expérience : nous lui avons demandé la définition de la sérendipité :
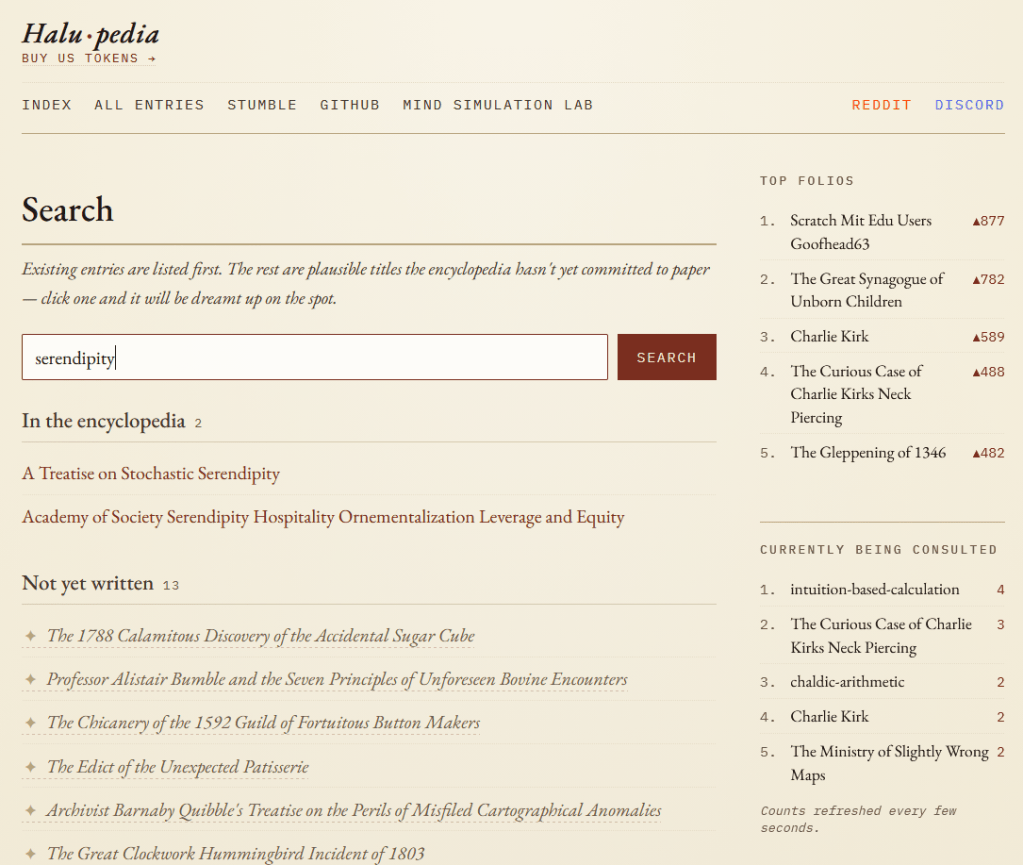
« Origines et développement
Le Traité A sur la sérendipité stochastique est une œuvre fondamentale qui a d’abord codifié le domaine de la sérendipité stochastique. Écrit par Oscar Penwick, sa publication en 1887 marque un tournant dans la compréhension d’événements bénéfiques apparemment aléatoires.
Avant le travail de Penwick, la sérendipité était largement considérée comme une qualité ineffable, un don de fortune accordé au perspicace. Penwick, cependant, a abordé le phénomène avec les outils rigoureux des mathématiques et des statistiques. Il a fait valoir que, bien que l’événement spécifique puisse être imprévisible, la *rate* et la *distribution* de tels événements pourraient être quantifiées et, dans une certaine mesure, prédites. Ses recherches ont été fortement influencées par des observations plus précoces et moins rigoureuses de personnalités telles que Barnaby Flumph et la Société Luddite de .
La sérendipité stochastique est le domaine d’étude consacré à l’évaluation quantitative des événements bénéfiques accidentels, en particulier ceux découlant de systèmes complexes et non linéaires. Son objectif principal est de développer des modèles prédictifs pour les accidents fortunés, permettant ainsi leur culture délibérée. La discipline a été formellement codifiée à la fin du XIXe siècle, bien que ses racines informelles puissent être attribuées à des efforts antérieurs dans le catalogage de découvertes inattendues »
La même question testée auprès de Wikipédia :
« La sérendipité est le fait de faire par hasard une découverte inattendue qui s’avère ensuite fructueuse, notamment dans le domaine des sciences. Il s’agit d’une notion polysémique dont le sens varie selon la période, le contexte et la langue utilisée.
Le mot anglais serendipity est créé en 1754 par l’écrivain Horace Walpole à partir du « conte persan » Voyages et aventures des trois princes de Serendip, de Cristoforo Armeno, publié en italien en 1557, puis traduit en français par Louis de Mailly en 1719. Walpole vient à connaître la traduction en anglais, publiée en 1722, de la version française.
Le nombre d’œuvres littéraires de fiction qui reposent sur l’idée de sérendipité va dès lors croissant : la découverte fortuite est le moteur de l’intrigue dans nombre de romans policiers ou de science-fiction.
Au milieu du XXe siècle, la sérendipité trouve une traduction dans le domaine de la recherche scientifique où elle fait l’objet d’une discussion sur la démarche du chercheur. Elle permet au chercheur de faire une découverte inattendue, d’importance ou d’intérêt supérieur à l’objet de sa recherche initiale, et désigne l’aptitude de ce même chercheur à saisir et exploiter cette « chance ». Mais elle trouve aussi son application dans des champs très divers, allant de la création artistique aux entreprises actives dans l’innovation, où les technologies numériques et Internet semblent jouer un rôle favorisant le phénomène de sérendipité.
Dans le monde francophone, le concept de sérendipité, adopté dans les années 1980, prend parfois un sens très large de « rôle du hasard dans les découvertes ».
Enfin, posons la question à une IGA (ici Gemmini 3.6 Flash) :
« La **sérendipité**, c’est l’art de faire une découverte inattendue et heureuse par hasard, souvent alors que l’on cherchait tout autre chose. Ce n’est pas juste de la « chance pure » : cela demande de la curiosité et un esprit ouvert pour remarquer ce résultat imprévu, en comprendre l’intérêt et savoir en tirer parti.
D’où vient ce mot ?
Le terme a été forgé en 1754 par l’écrivain anglais Horace Walpole, inspiré par le conte persan « Les Trois Princes de Serendip » (Serendip étant l’ancien nom du Sri Lanka). Dans ce conte, les princes passaient leur temps à deviner et découvrir des choses qu’ils ne cherchaient pas grâce à leur sens de l’observation et leur sagacité.
Quelques exemples célèbres :
- La pénicilline : Alexander Fleming a découvert cet antibiotique parce qu’une moisissure était venue accidentellement contaminer ses cultures de bactéries pendant ses vacances.
- Le Tarte Tatin : Une erreur de cuisson (des pommes oubliées dans le beurre et le sucre) a donné naissance à la célèbre pâtisserie renversée.
- Le Post-it : Un chercheur essayait de créer une colle superpuissante et s’est retrouvé avec une colle très faible qui ne laissait pas de traces… idéale pour les petits papiers jaunes. »
Ce qui frappe, c’est à la fois la cohérence (et incohérence) des 3 : les trois se complètent plus qu’ils ne s’annihilent, bien que Halupédia est le plus exotique. Mais on ne lui demande pas autre chose.
Halupedia : prouver la nécessité d’une IGA (vs IAG)
Cependant, ce qui nous intéresse derrière ce site, ce n’est pas tellement les hallucinations, mais la raison du site en lui-même et qui nécessite une balade plus approfondie dans leurs données.
Tout d’abord, la visite du site sans VPN vous amène à un hébergement en… Russie. Il est important de le savoir. Se pose alors la question de qui est derrière ces hallucinations d’IA ? Et c’est lorsqu’à la sérendipité de notre voyage dans le site que nous découvrons un travail remarquable sur le but de ces acteurs : démontrer que les IA hallucinent et donc, rechercher à tout prix une convergence vers l’IA générale (et non l’actuelle : générative).
Nous vous conseillons vivement la lecture de leur manifeste pour un guide de l’intelligence artificielle et leur table périodique du fonctionnement de l’intelligence artificielle démontre leur sens de la pédagogie.
Le guide présente l’intelligence artificielle comme un ensemble de technologies organisées selon trois grands paradigmes.
- L’approche descendante repose sur des règles et des connaissances explicites — systèmes experts, logique floue, réseaux sémantiques ou calcul des prédicats — offrant transparence et contrôle, mais une adaptation limitée.
- L’approche ascendante apprend à partir des données grâce aux méthodes statistiques, au machine learning, aux réseaux neuronaux, aux algorithmes génétiques et au calcul neuromorphique ; elle est plus flexible, mais exige beaucoup de données et de puissance de calcul.
- Enfin, l’approche hybride, privilégiée par Mind Simulation, cherche à combiner raisonnement symbolique, apprentissage automatique et systèmes multi-agents afin de produire des IA à la fois adaptables, explicables et robustes.
Et de conclure : derrière cette renaissance technologique se cachent trois approches fondamentales qui forment l’épine dorsale des solutions d’IA modernes: le paradigme descendant, s’inspirant du raisonnement humain; le paradigme ascendant, l’apprentissage des données brutes; et l’approche hybride, combinant le meilleur des deux mondes. Ensemble, ces méthodologies continuent de repousser les limites de ce qui est possible, en écrivant de nouveaux chapitres dans la quête en cours de l’humanité pour créer des machines vraiment intelligentes.
Logique hybride et multi-agents
Derrière ces acteurs, se trouve Embryo, avec Leo Derikiants, CEO de Mind simulation installée en Arménie (CQFD). Ce qu’ils définissent comme étant l’avenir, c’est le « paradigme hybride », qui est une combinaison magistrale de raisonnements décroissants traditionnels et de méthodologies d’apprentissage ascendantes contemporaines. Cette synergie puissante transcende les limites de chaque approche individuelle. Ce qui rend cette approche particulièrement remarquable, c’est sa polyvalence dans la gestion de données structurées et non structurées, et son amélioration continue de la performance grâce à l’interaction dynamique entre les connaissances expertes et les capacités d’autoapprentissage. Alors que les organisations sont confrontées à des défis de plus en plus complexes dans des environnements en évolution rapide, ces systèmes hybrides se distinguent par des solutions robustes, offrant le meilleur des deux mondes : la fiabilité de l’IA traditionnelle et l’adaptabilité de l’apprentissage automatique moderne.
Discussion
Nous ne pouvons pas leur donner tort sur l’avenir de l’IA dans une volonté de la rendre encore plus sûre dans un contexte où l’humain semble perdre pied dans les décisions liées à la vitesse de calcul des machines. L’exemple révélateur étant la guerre IRAN USA sur le détroit d’Ormouz avec Claude, laissant 50 secondes aux acteurs pour garantir la solution proposée…. Des vies étaient en jeu.
De la même manière que le dilemme du tramway avec les voitures autonomes et la position d’auteurs comme Alexei Grinbaum, directeur de recherche au CEA-Saclay, spécialiste de la théorie de l’information quantique. Et qui s’intéresse aux questions éthiques posées par les nouvelles technologies, notamment l’intelligence artificielle et la robotique.
Pour lui, la théorie des jeux répond à ce dilemme : la machine n’a pas à choisir.
Ici les auteurs proposent une approche plus singulière, faisant confiance à la fusion de la capacité de la machine avec les approches phénoménologiques et anthropomorphique humain dans la prise de décision, remplaçant l’algorithme par un humain répondant oui/non, la machine faisant le reste.
C’est probablement là un chemin nécessaire vers l’IAG, mais pas suffisant, car, avant cette fusion (à mon sens inéluctable), il faudra que l’humain fasse confiance pleinement envers la machine et donc ses algorithmes. Et pour avoir confiance, il faut que la machine ne se trompe plus… Cette étape nécessite des puissances de calcul incommensurable alors que les data centers deviennent un risque climatique majeur pour la société.
Bref, la question devient plus matérielle qu’algorithmique.
Conclusion
Cet article est un article de sérendipité : au moment où je me suis baladé sur Halupédia, je ne pensais pas découvrir ce que je vous ai résumé ci-devant et encore moins vous parler de l’IGA. La sérendipité et ce que nous en faisons sont un élément fondateur de l’approche algorithmique de l’IA car, si nous stockons dans notre esprit des liens qui se créent au fur et à mesure de nos lectures pour construire notre pensée, l’IAG doit encore se cantonner à une connaissance logique, bref, sans créativité.
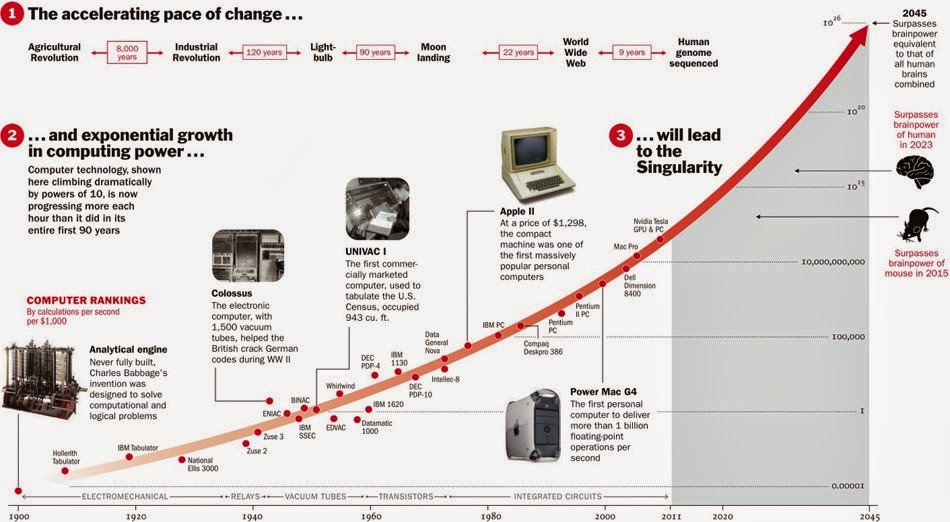
C’est cela qui fait encore la différence entre la machine et nous, mais pour combien de temps ? En 2013 je publiais une prévision sur base de la frise de Ray Kurzweil: l’arrivée de l’IGA dépendra de l’évolution de la technologie quantique.
Rien ne prouve le contraire encore aujourd’hui. Bonne et belle journée à vous.
Merci pour le suivi de notre blog-à-idées ou à réflexions, c’est toujours agréable d’être lu et vous êtes de plus en plus nombreux (+ de 1 000 par mois en, moyenne). N’hésitez pas à commenter, c’est aussi une place de débats. Et surtout, merci de partager/liker si vous soutenez nos réflexions ou recherches. C’est un véritable soutien de votre part et il est apprécié à sa juste valeur.
Dr. Pascal SIMOENS, Architecte et urbaniste, data Scientist.
J’ai commencé ma vie en construisant des villes en Lego, j’en ai fait mon métier. Geek invétéré, aujourd’hui je joins mes passions du numérique et de la ville au travers d’une expertise smart Cities et smart-buildings comme responsable » R&D au sein du groupe Pirnay (Charleroi-Bruxelles) et plus particulièrement de sa section S²Enginnering (smart & sustainable) . En même temps, j’enseigne cette expertise et continue la recherche dans les domaines de l’IA, l’architecture et la réduction de l’entropie du processus constructif au sien de l’UMONS. Je représente également les universités d’État de la communauté Française au sein du Conseil National de l’Ordre des architectes et du Conseil francophone et germanophone.
This post is licensed under a Creative Commons Attribution-NonCommercial 4.0 International License.

 NUMERIC LANDSCAPE
